“小明把杯子放在桌上,过了一会儿,又把它拿走了。”读到“它”时,我们会自然地联系前面的“杯子”。对模型来说,这个联系需要通过具体的计算建立:前面的信息放在哪里?当前的位置怎样找到它?如果两者之间隔着几千个词,还能不能找到?
MLP、CNN、RNN、Transformer 和 Mamba,给出了不同的信息处理方式。有的让相邻层全面连接,有的优先利用局部结构,有的把历史压缩成状态,还有的让不同位置直接交互。
Transformer 成为主流的一个关键原因,是它把灵活的长距离交互与高效的并行训练结合起来。 代价也很直接:当上下文变长,广泛的信息交互会消耗更多计算资源。Mamba 和混合架构则从历史信息的保存方式入手,寻找另一种取舍。
本文沿着修饼 xiubing 的神经网络架构视频展开,结合原论文补充关键边界。文中 8 张插图均为该视频的原始截图,每张图都附有回看时间。图中的数值、图标和连线用于解释机制,不代表真实模型的完整结构或实际测量结果。
从一个计算节点理解神经网络
文字、图片、声音进入模型以后,需要先被表示成数字。一个简单的神经网络节点,接收一组输入,将它们分别乘以权重、加上偏置,再经过非线性变换,输出新的数值。
可以把这一步理解为:
|
|
权重决定不同输入怎样影响结果,训练负责调整这些参数。大量节点组成一层,多层继续变换信息,最后产生分类、预测或生成所需的输出。
计算节点如何连接,决定了信息能从哪里来、经过哪些步骤、以什么形式保留下来。这正是理解架构的入口。
MLP 让相邻层全面连接
多层感知机 MLP 的典型结构,是把多个全连接层叠起来。下一层的每个节点,都可以读取上一层的全部输出。
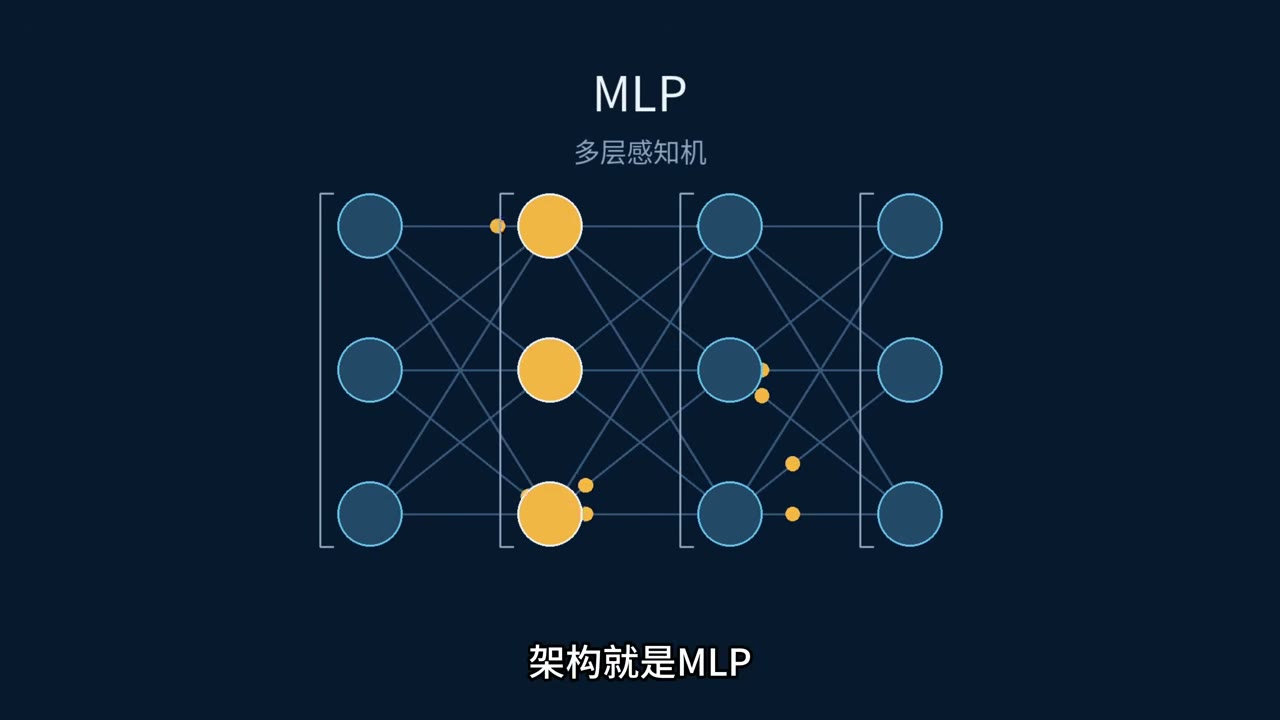
图 1:MLP 的全连接结构。相邻层中的节点通过带权重的连接传递信息。来源:修饼 xiubing,02:16。
这种结构简单、通用,但连接数量增长得很快。假设相邻两层各有 1,000 个节点,就需要 1,000 × 1,000,也就是 100 万个连接权重,还没有算偏置。
面对图片时,另一个问题出现了:像素并不是任意排列的一串数字。相邻像素常常共同构成边缘、纹理和局部形状;同一种形状也可能出现在图片的不同位置。把整张图展平成向量后交给全连接网络,这些空间规律需要网络自行学会。
如果直接把这些规律放进连接方式里,就可以更有针对性地处理图片。
CNN 把空间规律放进网络
卷积神经网络 CNN 的两个关键设计是局部连接和权重共享。
每个位置先处理附近的信息
以一个 3×3 卷积窗口为例,一个输出位置先关注输入中的一小块邻域。窗口移动到别的位置,就计算那个位置的局部特征。许多局部计算共同形成整张特征图。
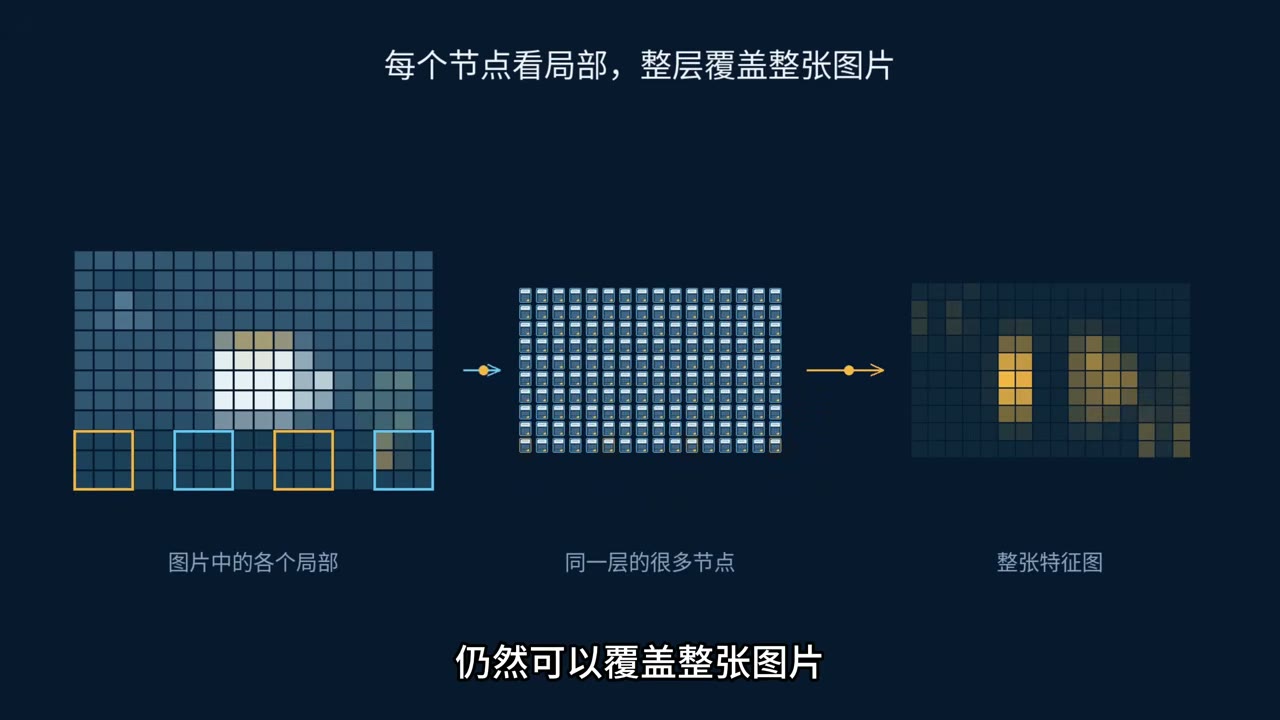
图 2:单个计算位置读取局部邻域,整层输出仍能覆盖整张图片。来源:修饼 xiubing,03:26。
识别杯子时,前面的层可以提取边缘或颜色变化,后面的层继续组合局部形状,再形成更大范围的特征。随着网络加深,一个输出能够受到更大范围输入的影响,这个范围通常称为感受野。
“边缘到形状再到物体”是帮助理解的示意。真实网络的各层特征由训练形成,不需要人为指定某一层只能识别杯把,另一层只能识别杯口。
同一个卷积核可以用于不同位置
假如某组参数能够检测竖直边缘,那么它在左上角有用,在中间和右下角也可能有用。CNN 让同一个卷积核在不同空间位置重复使用,从而减少需要独立学习的参数。
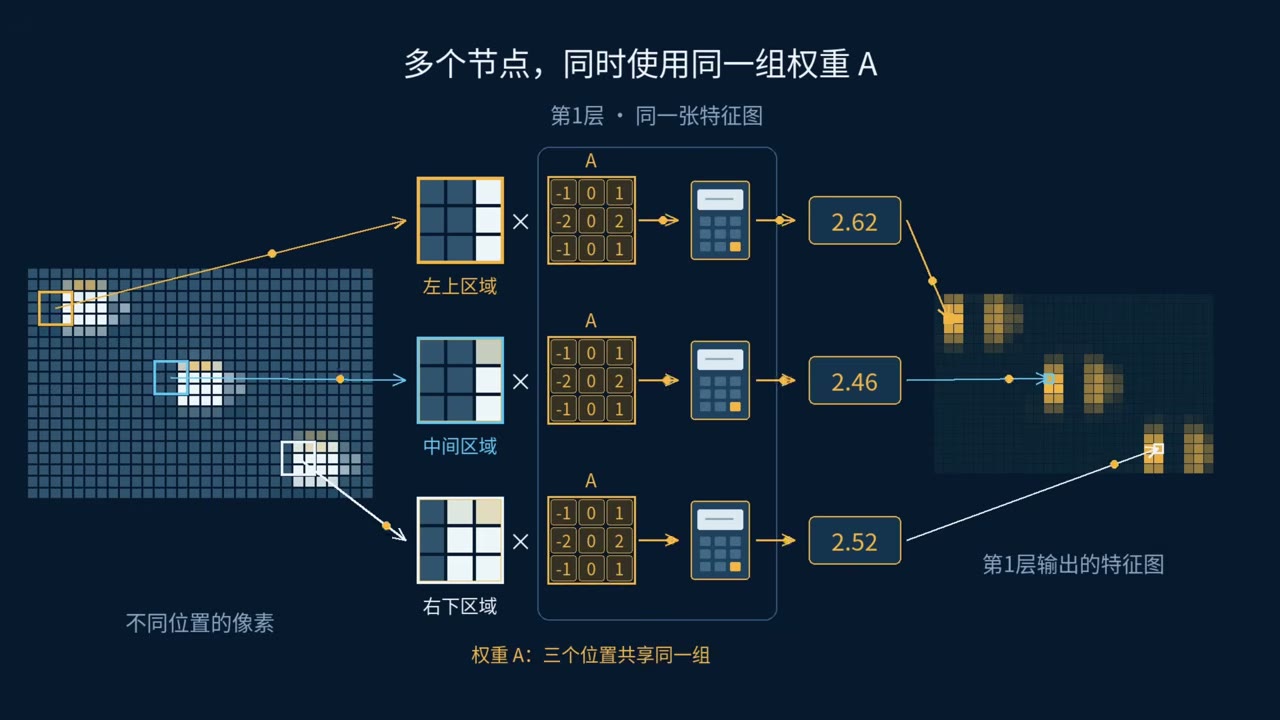
图 3:三个位置共享权重 A,但输入不同,因此分别计算并得到各自的输出。来源:修饼 xiubing,04:06。
这里共享的是同一个卷积核的参数,各位置仍然需要计算。一个卷积层也可以包含多个不同的卷积核,学习不同的特征;不能把权重共享理解成整层只能使用一套参数。Stanford CS231n 卷积网络讲义
CNN 把图片的局部性和空间复用规律纳入了架构。换成文本以后,另一个问题会更加突出:如何让后面的输入知道前面发生了什么?
RNN 用一个状态传递历史
回到开头的句子。模型处理“它”时,必须获得此前关于“杯子”的信息。
循环神经网络 RNN 的做法,是按顺序处理输入。每一步同时接收当前输入和上一时刻的隐藏状态,计算出新的状态,再传给下一步。隐藏状态是一组数字,用来承载模型从历史输入中保留的信息。
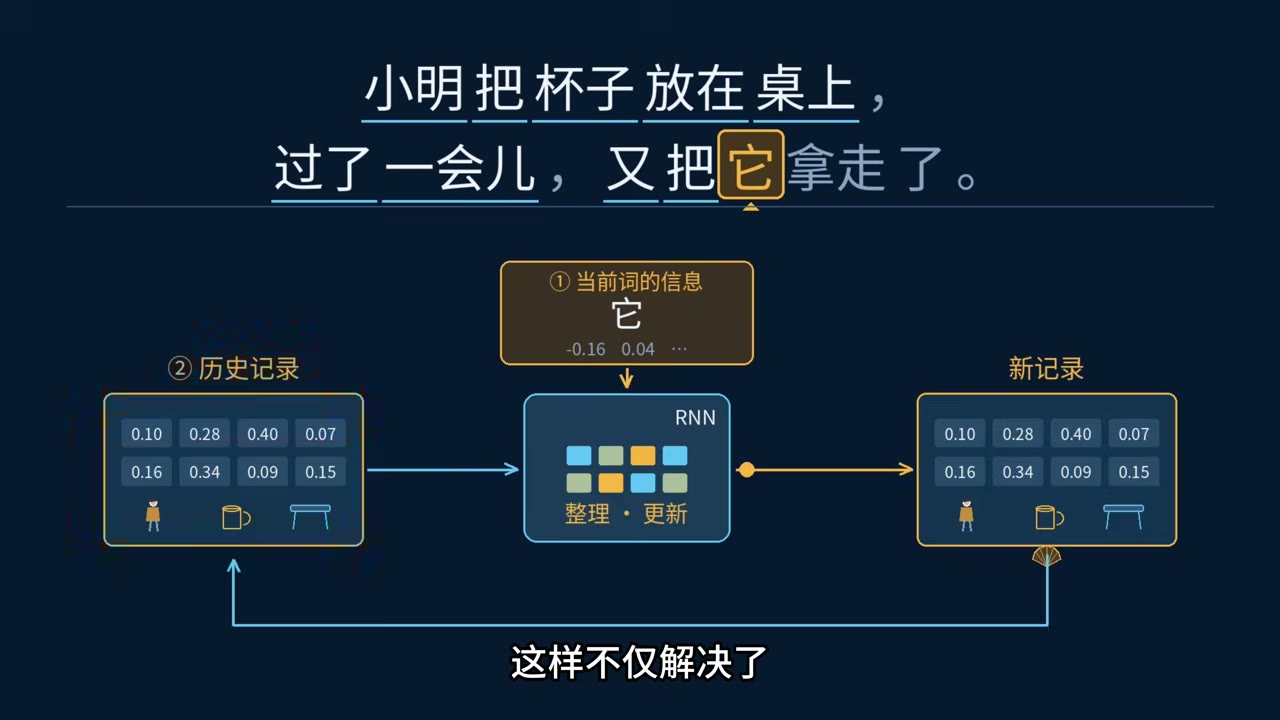
图 4:RNN 不断结合当前输入与历史记录,生成新的状态。来源:修饼 xiubing,05:42。
这个过程像一张不断改写的纸条:读入新内容,更新纸条,再带着它继续阅读。只要需要的信息保留在状态里,后面的位置就有机会使用它。
困难在于,一篇很长的文章会让这张纸条经历很多次改写。第 3,000 个位置需要第 10 个位置的细节时,普通 RNN 依靠的是前面不断更新的状态,无法直接跳回原来那个位置读取表示。长距离依赖因此更难学习和保留。
同时,后一步的状态依赖前一步。这限制了单条序列沿时间方向的并行计算。不同样本等维度仍然可以并行,问题主要在于这条递推链本身。Transformer 原论文 §1
这就引出了一个想法:如果当前输入需要很远以前的信息,能否直接建立联系?
Transformer 用注意力建立直接联系
Transformer 的核心机制之一是自注意力。它让一个位置根据当前内容,计算与其他可访问位置的关联,并把这些位置的信息按不同权重组合起来。
在“它”的例子里,“杯子”可能获得更大的权重,“小明”和“桌上”的权重较小。这样,“它”的表示就能够融入相关上下文。
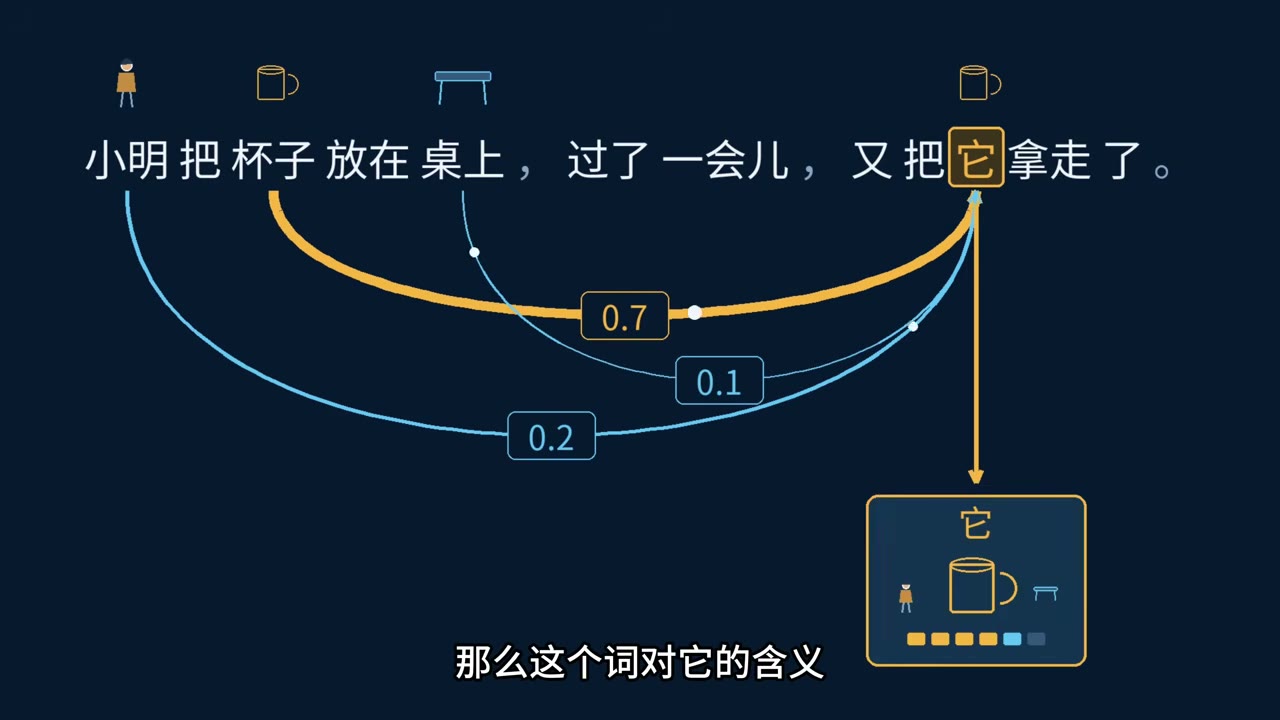
图 5:图中的 0.7、0.2、0.1 是教学假设,用来说明加权组合。它们不是固定的词语关系,也不是经过测量的指代概率。来源:修饼 xiubing,07:20。
图中按中文词语解释流程。实际文本模型通常处理 token,它可能是一个字、词的一部分或其他文本片段。
注意力权重会随输入改变
理解自注意力时,很容易混淆两种“权重”。
一类是模型参数,例如把输入表示变换成 Query、Key、Value,也就是 Q、K、V 的投影矩阵。这些参数由训练学得。另一类是当前计算产生的注意力权重:模型比较 Q 和 K,再用得到的权重组合 V。
因此,同一个词出现在不同句子里,可以关注不同的信息。这种变化发生在计算结果上,通常不意味着模型在每次回答时都重新训练了参数。Transformer 原论文 §3.2
长距离交互与并行训练可以兼得
自注意力让距离较远的位置有了直接的信息通路。给定整段训练序列后,许多位置的相关计算也能一起组织成矩阵运算,适合 GPU 大规模处理,减少了普通 RNN 在序列方向上逐步等待的限制。
训练自回归语言模型时,causal mask 会限制每个位置访问未来的输入位置。并行计算所有训练位置,不代表允许模型偷看答案。 自回归生成时,新 token 仍然依赖已经生成的内容,输出通常还要逐步推进。Transformer 原论文 §3.1
这种灵活的信息交互方式,可以在输入经过适当表示后用于文字、图像、声音等不同模态。长距离建模能力、并行训练效率,加上长期积累的训练方法与硬件实现,共同构成了 Transformer 的优势。
广泛的信息交互也有成本
标准全自注意力要考虑位置之间的大量配对。当序列长度从 1,000 增长到 10,000,位置对的数量会从约 100 万增长到约 1 亿。
原论文将标准自注意力每层的主要计算复杂度写为 O(n²d),其中 n 是序列长度,d 是表示维度。这个式子描述特定计算部分,不能直接当作整个模型耗时,或所有注意力实现的显存公式。Transformer 原论文 §4
长上下文让一个问题变得更有吸引力:能否用较小的状态,保留后续真正需要的信息,减少反复进行大范围注意力计算的开销?
Mamba 让状态更新具有选择性
Mamba 属于选择性状态空间模型,也就是 selective SSM 路线。它一边处理输入,一边更新内部状态。已经处理过的信息,通过状态影响后续计算。
它与 RNN 都有递推状态,但 Mamba 使用了特定的状态空间结构。关键之处在于,部分状态空间参数会随当前输入变化,从而控制信息怎样写入、保留和读出。
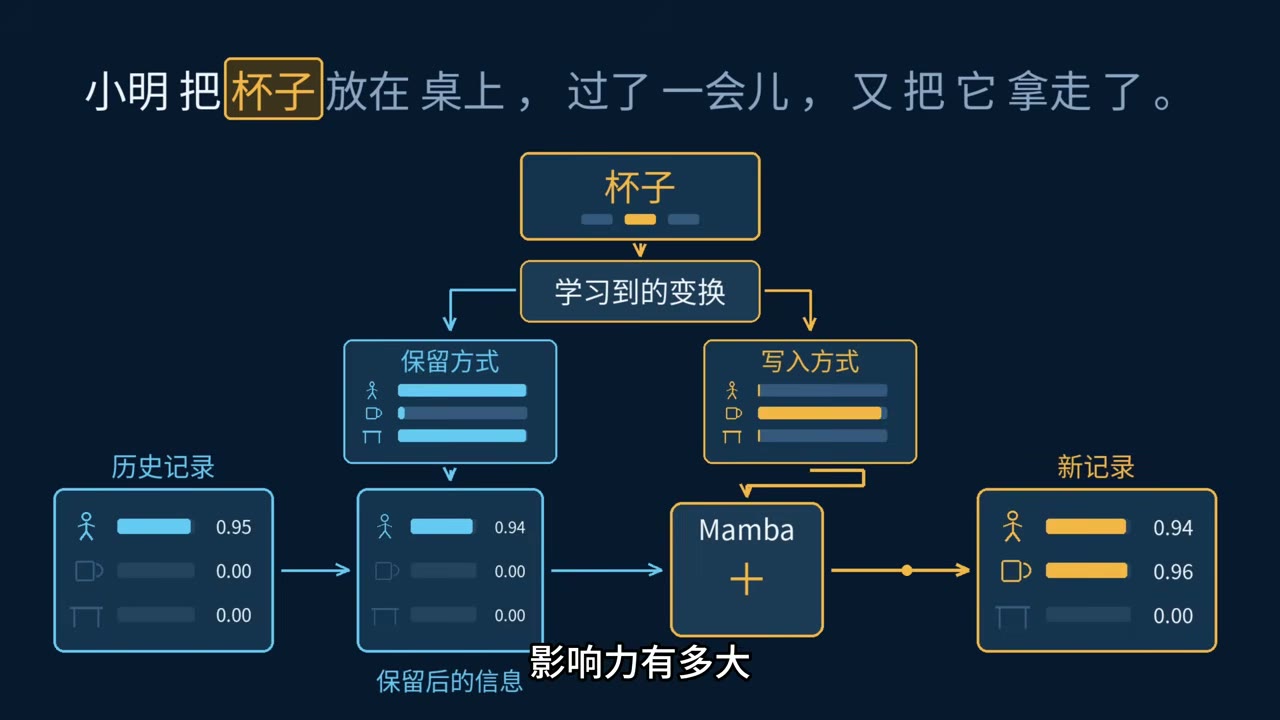
图 6:当前输入经过学得的变换,影响状态的保留与写入方式。图中的人物、杯子和数值是便于理解的示意。来源:修饼 xiubing,09:34。
可以把这种选择性理解为:不同输入以不同方式影响状态。它由训练学得,不是人为给每个词写一条“重要就保留”的判断规则。
Mamba 还针对这类结构设计了硬件优化的 parallel scan,也就是并行扫描算法,用来高效计算整段序列。保留递推状态的表达方式,并不要求训练时完全按照普通 RNN 的执行方式逐个等待。Mamba 原论文 §3
对于给定的模型结构,状态的规模不必随着已处理序列的长度持续增长。这使它能够避免标准全注意力的全部位置两两交互,提供高效处理长序列的另一条路线。
压缩历史与直接访问之间的取舍
保存一份状态能够降低成本,但状态需要承载哪些细节,是模型必须解决的问题。
Attention 可以从仍在可访问范围内的位置表示中获取信息;状态模型则依赖已经写入状态的内容。两者对精确检索、上下文长度、计算资源的取舍并不相同。
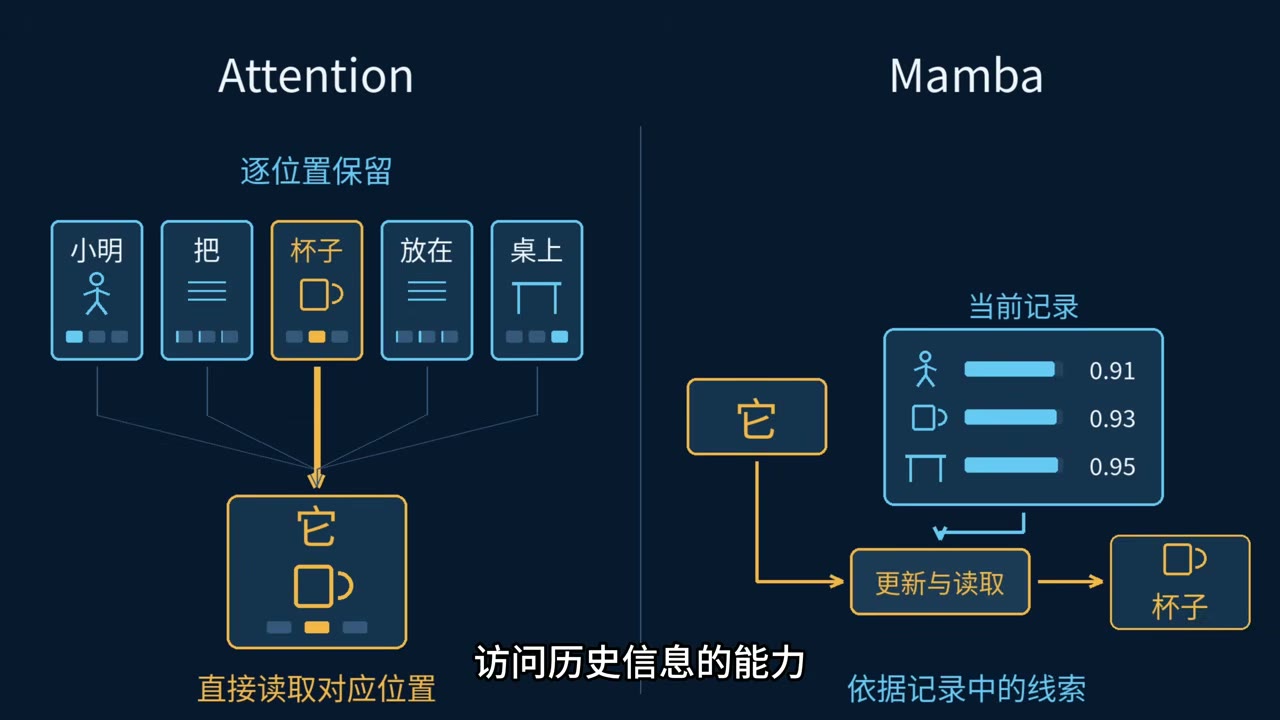
图 7:左侧直接关联保留的位置表示,右侧从压缩状态中利用历史线索。来源:修饼 xiubing,10:18。
这并不意味着 Mamba 必然忘记远处的信息,也不意味着 Attention 能无误找回所有细节。更有用的比较方式,是看具体任务需要什么:持续处理长数据流,还是精确关联分散在上下文里的细节?允许多少内存和计算成本?
混合架构把不同机制放在一起
一种自然的设计,是在同一个模型中组合不同模块。部分层使用状态空间结构,部分层使用注意力,再配合前馈网络处理特征。
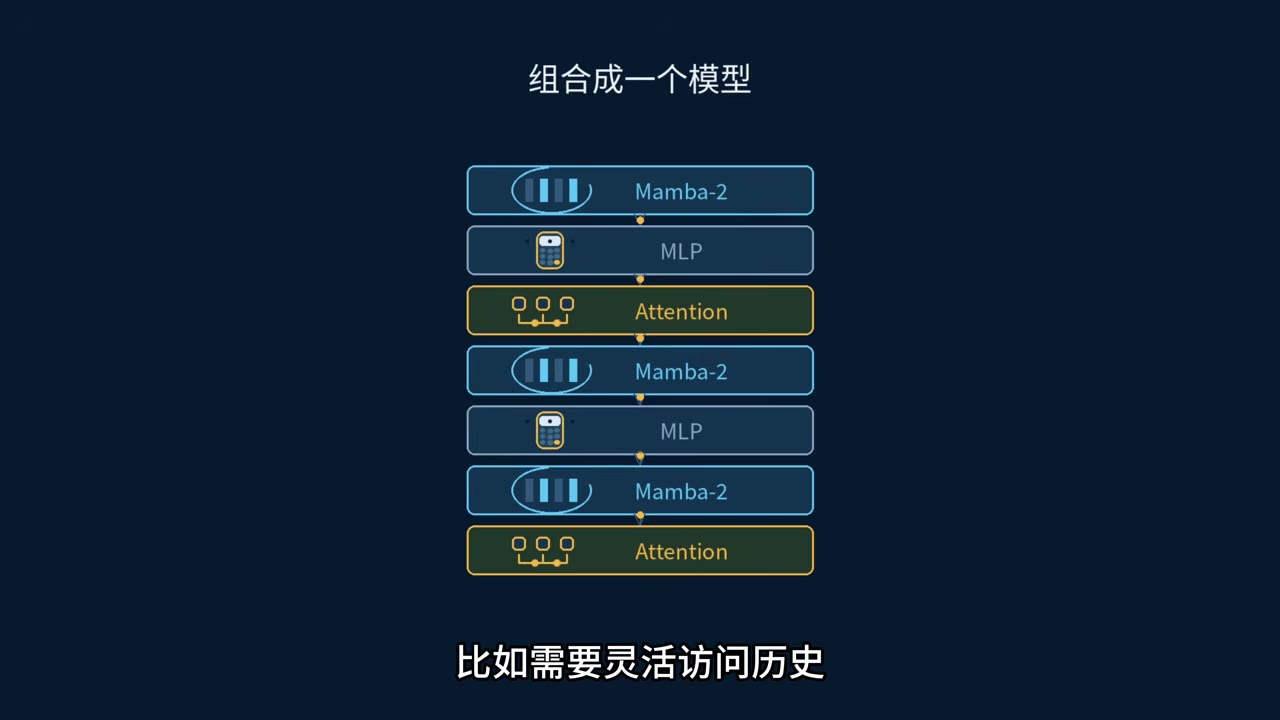
图 8:Mamba-2、MLP 和 Attention 可以组成一个混合模型。图中是结构示意,不对应所有模型的固定层数或比例。来源:修饼 xiubing,10:33。
视频提到的 NVIDIA Nemotron-H 就是一个实例。NVIDIA 的官方介绍说明,它采用 Mamba-2、Self-Attention 和 MLP 的混合结构。这说的是模型模块的组合,并不表示每个 token 都会临时在几种架构之间切换。NVIDIA Nemotron-H 官方介绍
MLP、CNN、RNN、Transformer、Mamba 也因此不能简单排列成一条淘汰链。原始 Transformer 内部本来就包含逐位置前馈网络;不同结构可以继续在各自适合的任务或更大模型中发挥作用。Transformer 原论文 §3.3
用信息处理方式比较架构
| 架构 | 信息怎样组织 | 主要收益与取舍 |
|---|---|---|
| MLP | 相邻层全连接 | 通用;宽层之间的参数量容易变大 |
| CNN | 局部邻域计算,同一卷积核跨位置复用 | 利用空间规律;需要逐层扩大信息覆盖范围 |
| RNN | 当前输入与历史状态递推 | 适合顺序处理;长距离依赖和时间方向并行受限 |
| Transformer | 注意力直接关联可访问的位置 | 交互灵活、训练易并行;标准全注意力的长序列成本高 |
| Mamba | 用输入相关的规则更新状态 | 长序列处理高效;需要在有限状态中保留有用细节 |
以后遇到一种新架构,可以先看四件事:一个位置能连接哪些信息,历史是逐位置保留还是压缩保存,调用远处信息需要经过几步,以及这些设计怎样影响计算量和并行效率。
带着这些问题再读架构名称和性能指标,才容易看清它解决了什么问题,以及代价落在了哪里。